「AIが使えない」のは背景が分からないから、意味付けを自動化する国産基盤の真価:製造マネジメント インタビュー(1/2 ページ)
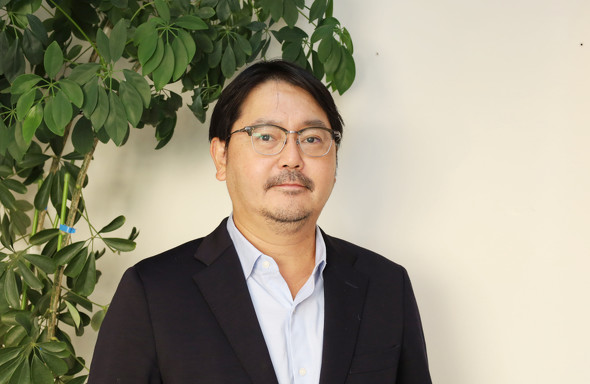
製造業のAI活用では、社内に蓄積されたデータをAIが活用できる状態に整備することが課題となっている。エフティーは、データの意味付けや関係性の構造化をほぼ自動で行う「Kraken.」を開発した。同社の取り組みについて、エフティー 代表取締役の加藤大雄氏に話を聞いた。
データを入れるだけで自動で意味付けされて保管されるようになれば――。
あらゆる業務でAI(人工知能)の活用が広がっている。ただ、一般業務でのAI活用は進んでいるものの、専門業務での活用については、期待した精度が得られず、導入が進まないケースも多い。製造業のAI活用において、その要因として「データがない」ことが挙げられているが、実際には多くのデータが保有されており、本当の課題は「データがAIで使える状態になっていない」ということである。
こうした企業内の情報を意味情報も含めて可視化/構造化し、「データをAIが使える状態にする」ことを自動で実現するのが、エフティーの「Kraken.(クラーケン)」だ。同製品は、企業内に分散する構造化データや非構造化データを体系化し、業務上の概念や関係性を表すオントロジーモデルを自動で構築する。既に多くの大手製造業で試験導入が始まっているという。オントロジーモデルで注目を集めるPalantirの日本版企業の1つとして注目を集める同社の取り組みについて、エフティー 代表取締役の加藤大雄氏に話を聞いた。
“データの精製所”を目指し「Kraken.」を開発
エフティーは2007年にマーケティング支援事業を出発点として設立された。その後、2019年からオントロジーモデルに注目した開発をスタートし、2022年にナレッジ型データメッシュプラットフォーム「Kraken.」の提供を開始した。その後、2026年には会社の体制を改め、新設分割して再出発している。
Kraken.はデータメッシュアーキテクチャを採用しており、企業データの文脈や関係性、出典をメゾデータとして構造化し、AIが根拠へ逆引きできる「意味空間」の構築を自動で行える。各ビジネスドメインがそれぞれデータを所有、管理できるようにしつつ、意味空間としては共通化しているため、それぞれがデータの業務上の意味や価値を理解しながら、必要なデータを活用できる。

意味空間とは、会社のノウハウや業務ルール、判断基準を構造化し、AIが企業データを“業務上の意味”として正しく扱える状態をつくる土台だ。意味空間がない場合、AIはデータの持つ意味や背景を理解できないため、その都度状況によって異なる回答を出すなど、回答の再現性が低くなる可能性がある。企業固有の意味が構造化されていれば、回答の再現性が高まる他、それに伴い検算のコストを低減できる。さらにナレッジの資産化などにもつながる。

Kraken.の開発について加藤氏は「ちょうどPalantirなどに注目が集まった頃で、分散したデータを使えるようにする『データリファイナリー(データの精製所)』としての役割が重要になると考えていた。その中でデータ主権などの問題から、日本でそういうことができる企業が必要になると考えて開発に取り組んだ。米国IT先端企業での開発経験などもあるCTOの北口の技術力と発想で、約3年をかけて半自動で意味空間の構築が可能な仕組みを形にすることができた」と振り返る。
Copyright © ITmedia, Inc. All Rights Reserved.